Magazin Automatisierte Deployments mit GitLab: So gehen Website-Änderungen kontrolliert live
Montagmorgen, die erste E-Mail der Woche: „Auf der Website stimmt seit gestern etwas nicht.“ Was am Vortag genau veröffentlicht wurde, kann niemand auf Anhieb sagen. Ohne automatisiertes Deployment ist das keine Seltenheit, denn dann hängt jeder Livegang an Handarbeit und am Gedächtnis einzelner Personen.
Viele Unternehmen prüfen sehr genau, was an ihrer Website geändert wird. Wie die Änderung online geht, bekommt dagegen kaum Aufmerksamkeit. Weil Websites längst Vertrieb, Marketing und Service tragen, werden sie laufend angepasst, und jeder Livegang macht eine geschäftsrelevante Änderung öffentlich. Ein Deployment ist deshalb kein rein technischer Vorgang. Es ist eine geschäftliche Entscheidung, und die sollte nicht dem Zufall überlassen werden.
Was bei manuellen Veröffentlichungen typischerweise schiefgeht, warum Automatisierung mehr ist als Entwickler-Komfort und woran Sie einen professionellen Prozess erkennen, ohne selbst eine Pipeline bauen zu müssen: Das ordnen wir hier ein.

Das Wichtigste in Kürze
- Livegang mit Geschäftsfolgen: Ein Deployment macht eine geschäftsrelevante Änderung öffentlich und ist damit eine Entscheidung, kein technisches Detail.
- Manuelle Veröffentlichungen skalieren schlecht: Sie sind fehleranfällig, schwer nachvollziehbar und hängen oft an einer einzelnen Person.
- Nicht jeder Fehler ist sichtbar: Ein überschriebenes Conversion-Tracking kostet Leads und Budget, obwohl die Website völlig normal aussieht.
- GitLab CI/CD schafft Nachvollziehbarkeit: Definierte Schritte, Staging vor Live, bewusste Freigaben, dokumentierte Veröffentlichungen und ein vorbereiteter Rückweg machen jeden Livegang überprüfbar.
- Automatisierung nach Risiko bemessen: Kleine Websites brauchen einfache, saubere Abläufe, geschäftskritische Systeme stärkere Kontrollen.
Warum der Zeitpunkt Ihres Website-Livegangs eine strategische Entscheidung ist
Eine Unternehmenswebsite ist Vertriebsplattform, Marketingkanal, Recruitinginstrument und Serviceportal zugleich. Oft ist sie ein zentraler Teil der digitalen Infrastruktur. Entsprechend häufig ändert sie sich.
Kampagnen-Landingpages müssen kurzfristig online gehen, Tracking-Setups werden angepasst, SEO-Optimierungen veröffentlicht. Sicherheitsupdates dulden keinen Aufschub, Formulare und Schnittstellen entwickeln sich weiter. Größere Relaunch-Arbeiten laufen meist parallel zum Tagesgeschäft.
Jede dieser Änderungen hat einen Moment, in dem sie öffentlich wird: das Deployment, also die Veröffentlichung auf dem Live-System. Geht dabei etwas schief, bleibt das selten ein rein technisches Problem. Die Folgen landen bei Marketing und Vertrieb: verlorene Leads, fehlerhaftes Tracking, eine schlechte Nutzererfahrung, SEO-Probleme oder unnötige Ausfallzeiten.
Daraus ergibt sich eine einfache Rechnung. Je häufiger Sie veröffentlichen, desto teurer wird ein Website-Deployment, das nur zufällig funktioniert.
Was bei manuellen Deployments schiefgeht: 4 Szenarien
Bei einem manuellen Deployment überträgt jemand geänderte Dateien von Hand auf den Server, etwa per FTP, SSH oder mit selbst gepflegten Skripten. Für Außenstehende wirkt das harmlos.
Wer schon lange in der Webentwicklung tätig ist, kennt das Problem aus der Zeit vor automatisierten Deployments: Wenn Code-Anpassungen nicht dem Stand im Repository entsprechen. Manche Änderungen wurden direkt auf dem Server vorgenommen und tauchten in der Versionierung nicht auf. Beim nächsten Upload wurden sie überschrieben, und Seiten funktionierten plötzlich nicht mehr.
Wie unterschiedlich sich solche Fehler äußern können, zeigen 4 typische Szenarien.
-
01
Der stille Tracking-Fehler
Eine Kampagnen-Landingpage wird manuell veröffentlicht. Dabei wird versehentlich eine Tracking- oder Conversion-Konfiguration überschrieben. Für Besucher:innen sieht die Seite völlig normal aus, nur werden Conversions nicht mehr korrekt gemessen.
Die Google Ads oder Social Ads laufen derweil weiter. Leads lassen sich keiner Kampagne mehr zuordnen, die Auswertung wird unbrauchbar, und oft fällt das erst Tage später auf. Nicht jeder Deployment-Fehler ist also sichtbar. Manche kosten Geld, ohne dass die Website kaputt wirkt.
-
02
Der Single Point of Failure
Nur eine Person im Team kennt den genauen Ablauf, mit dem Änderungen live gehen. Ausgerechnet jetzt ist sie krank oder im Urlaub, während ein dringendes Sicherheitsupdate oder ein Hotfix, also eine schnelle Fehlerkorrektur, veröffentlicht werden muss.
Das Update verzögert sich, andere im Team müssen improvisieren, und mit jedem improvisierten Schritt steigt das Fehlerrisiko. Spätestens hier zeigt sich: Ein Deployment-Prozess darf nicht nur im Kopf einer einzelnen Person existieren.
-
03
Testen auf der Live-Website
Eine Änderung geht ohne verlässliche Staging-Umgebung direkt live. Staging bezeichnet eine Testumgebung, die dem Live-System möglichst genau entspricht und in der sich Änderungen vor der Veröffentlichung prüfen lassen. Fehlt sie, wurde die Änderung nur lokal auf dem Entwicklungsrechner getestet. Auf dem Produktivsystem, also der Live-Website, verhalten sich Cache, Serverkonfiguration oder externe Schnittstellen aber anders.
Unterseiten sind dann zeitweise nicht erreichbar, Formulare funktionieren nicht, Inhalte werden falsch ausgespielt. Meist bemerken Nutzer:innen oder Kund:innen den Fehler vor dem eigenen Team. Wer keine Staging-Umgebung hat, testet im Zweifel auf der Live-Website. Und auch eine vorhandene Staging-Umgebung hilft nur, wenn sie sich nicht zu stark vom Live-System unterscheidet.
-
04
Unklarheit nach dem Fehler
Nach einem Livegang tritt ein Problem auf, und die naheliegenden Fragen bleiben offen: Welche Änderung wurde veröffentlicht? Wer hat sie live gestellt? Wurde vorher getestet? Welche Version war vorher online? Und kommen wir schnell dorthin zurück?
Ohne nachvollziehbaren Prozess wird Fehleranalyse zur Detektivarbeit. Während das Team rekonstruiert, was passiert ist, bleibt der Fehler online. An genau dieser Stelle setzt ein automatisierter Deployment-Prozess an.
Was ein automatisierter Deployment-Prozess konkret verändert
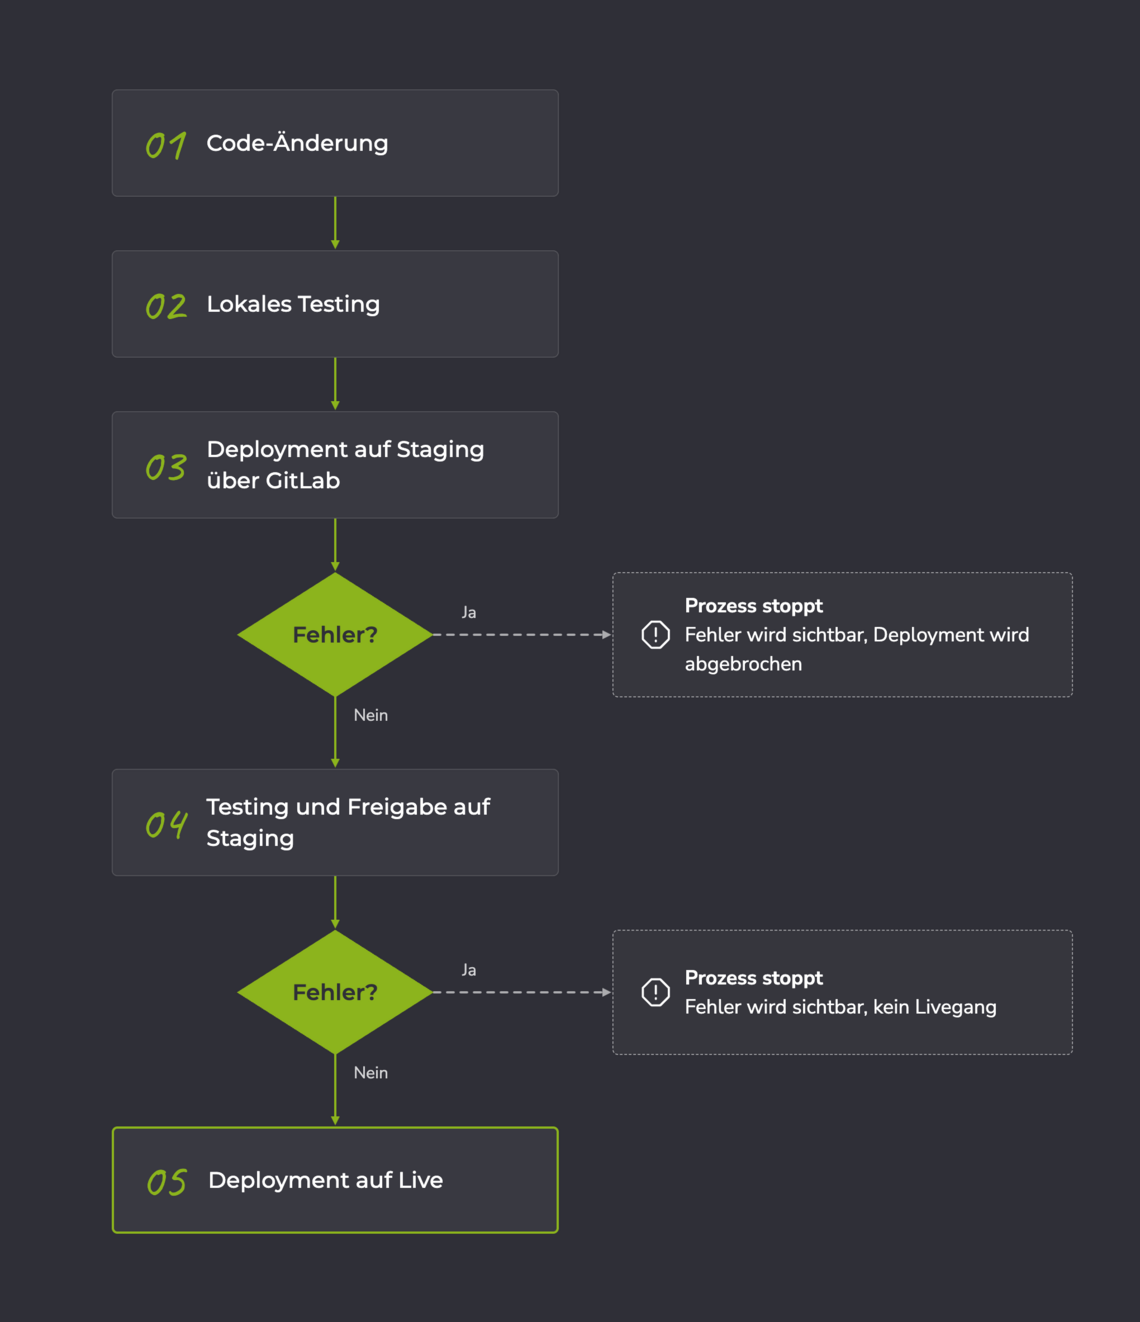
Ein automatisiertes Deployment ersetzt manuelle Einzelschritte durch einen festgelegten Ablauf, der bei jeder Veröffentlichung gleich abläuft. Der Gewinn liegt dabei weniger in der Geschwindigkeit als in Kontrolle und Nachvollziehbarkeit.
Der entscheidende Punkt steckt in den Prüfschritten. Schlägt einer davon fehl, stoppt der Prozess. Der Fehler wird sichtbar, bevor er auf der Live-Website landet, und der Livegang findet gar nicht erst statt.
Das deckt sich mit der Einordnung des DevOps-Forschungsprogramms DORA von Google Cloud: Je mehr manuelle Schritte eine Veröffentlichung enthält, desto länger dauert sie und desto mehr Gelegenheiten für Fehler entstehen. DORA empfiehlt außerdem, für Test- und Produktivumgebung denselben Deployment-Prozess zu nutzen.
Den Unterschied haben wir selbst erlebt. Ohne automatisiertes Deployment wurden Änderungen in Projekten teilweise händisch per SCP oder Rsync, also über einfache Kopierbefehle, auf den Server übertragen. Das wirkt unkompliziert, erzeugt aber bei jedem Livegang zusätzlichen Kontrollaufwand: Welche Dateien werden übertragen? Wird dabei etwas anderes überschrieben? Ist der veröffentlichte Stand wirklich der richtige? Das kostet Zeit und macht den Prozess anfällig für menschliche Fehler.
Manuelle Deployments sind deshalb nicht automatisch schlecht. Sie skalieren nur schlecht. Mit jeder zusätzlichen Person, jedem weiteren Release und jeder neuen Umgebung wächst der Kontrollaufwand. Ein gutes Deployment ist kein Glücksfall, sondern ein definierter Prozess.
Eine Abgrenzung ist dabei wichtig: Automatisierung ersetzt nicht die fachliche Freigabe. Ob eine Landingpage inhaltlich stimmt, entscheiden weiterhin Sie oder Ihr Team. Die Automatisierung sorgt dafür, dass diese Freigabe kontrolliert umgesetzt wird.
Praxis-Deep-Dive: Backend & TYPO3 – Core First und die Asset-Pipeline als Lehrstück
Was steht in einem Regelwerk eigentlich drin? Im Backend vor allem Prüfreihenfolgen und Architekturentscheidungen. Seit dem 21. April 2026 ist TYPO3 v14 als LTS-Version 14.3.0 verfügbar. Sie setzt mindestens PHP 8.2 voraus und unterstützt PHP bis Version 8.5. Die Neuerungen in TYPO3 v14 fließen direkt in unser Regelwerk ein.
Die wichtigste Regel heißt Core First. Bevor der Agent etwas baut, prüft er in fester Reihenfolge: Gibt es eine Core-API? Gibt es eine Lösung im vendor/-Ordner? Erst danach entsteht eine eigene Extension. Eigene Inhaltselemente definieren wir mit Content Blocks statt mit veralteten Mask-Konfigurationen.
Für Assets gilt eine noch strengere Vorgabe. CSS, JavaScript und Bilder werden auf genau einem zugelassenen Weg ausgeliefert, über eine interne Asset-Einbindungs-Extension. Ohne diese Regel entstehen typische Fehlgriffe, bei Agenten genauso wie bei Menschen:
- Stylesheet direkt im Template: Ein <link rel="stylesheet"> im Fluid-Template statt über den vorgesehenen ViewHelper blockiert das Rendering, wird nicht minifiziert und nicht verzögert geladen.
- <img> statt <picture>: Es fehlen srcset, moderne Bildformate, loading="lazy" und oft width und height. Die Folge sind Layout-Verschiebungen (CLS), die sich in den Pagespeed-Werten niederschlagen.
- Eine eigene Build-Pipeline: Der Agent führt eine Node-Build-Pipeline ein, obwohl SCSS serverseitig kompiliert wird. Diese Architekturentscheidung hat ihm niemand übertragen, und kein Linter kann sie prüfen.
Lighthouse meldet im ersten Fall zwar „render-blocking resources“, sagt aber nicht, welchen Weg der Agent hätte nehmen sollen. Die Regel verhindert den Fehler, die Metrik entdeckt ihn nur. Für den dritten Fall gibt es nicht einmal eine Metrik.
Was GitLab CI/CD aus Prozesssicht leistet
Viele kennen GitLab als Ablage für Quellcode. Mit GitLab CI/CD wird die Plattform zur Steuerzentrale für kontrollierte Veröffentlichungen. CI/CD steht für Continuous Integration und Continuous Delivery beziehungsweise Continuous Deployment, also das laufende Zusammenführen, Prüfen und Ausliefern von Änderungen.
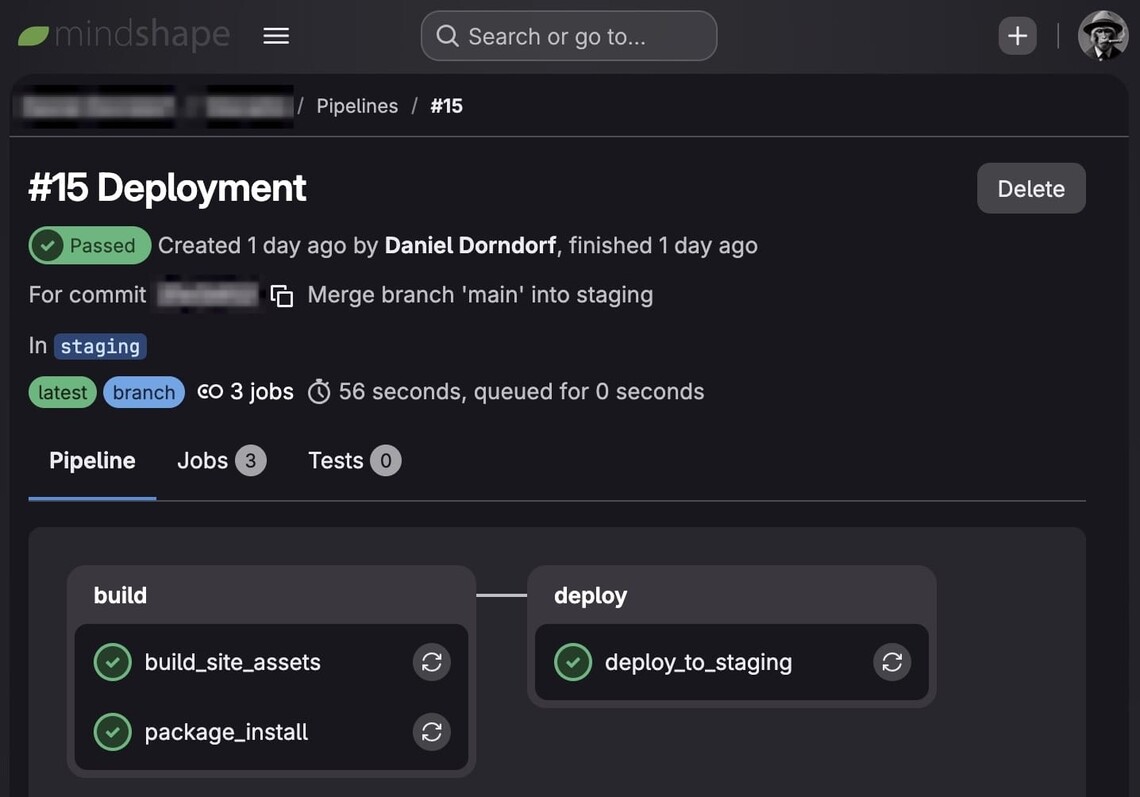
Den Ablauf bildet GitLab in einer sogenannten CI/CD-Pipeline ab. Vereinfacht gesagt ist das eine Abfolge definierter Schritte: prüfen, vorbereiten, auf Staging veröffentlichen, freigeben und live stellen. Wie diese Deployment-Pipeline technisch gebaut ist, müssen Sie nicht wissen. Entscheidend ist, was sie im Alltag leistet:
- Einheitliche Schritte: Jede Veröffentlichung läuft gleich ab, unabhängig davon, wer sie anstößt.
- Getrennte Umgebungen mit Historie: Staging und Live sind sauber getrennt, und für jede Umgebung ist dokumentiert, welche Version wann veröffentlicht wurde.
- Sichtbare Prüfungen: Automatische Tests und Prüfungen decken Fehler früh auf. Ob ein Deployment erfolgreich war oder wo es gescheitert ist, sieht das ganze Team.
- Bewusste Freigaben: Der Schritt auf das Produktivsystem lässt sich so einrichten, dass er manuell ausgelöst werden muss. Geschützte Umgebungen legen zudem fest, wer überhaupt live stellen darf.
- Sichere Zugangsdaten: Passwörter und Schlüssel liegen als geschützte und maskierte Variablen in GitLab statt auf einzelnen Rechnern.
- Vorbereiteter Rückweg: Ein Rollback, also die Rückkehr zum vorherigen Stand, gelingt durch erneutes Ausrollen eines früheren erfolgreichen Deployments.
Diese Funktionen beschreibt die GitLab-Dokumentation zu Umgebungen und Deployments im Detail. Für Website-Verantwortliche zählt vor allem die Summe daraus, und die heißt Nachvollziehbarkeit. Genau darin liegt der größte Vorteil von GitLab CI/CD, mehr noch als in der Geschwindigkeit. Auf die Frage „Was ist gestern live gegangen?“ gibt es eine Antwort, ohne dass jemand suchen muss.
Auch die Sorge, dass jeder Livegang ein Wartungsfenster braucht, lässt sich entkräften. Ergänzende Werkzeuge wie Deployer, ein Open-Source-Tool für PHP-Projekte wie TYPO3, WordPress oder Shopware, schalten laut Hersteller erst dann auf die neue Version um, wenn diese vollständig bereitsteht. Besucher:innen sehen so zu keinem Zeitpunkt einen halbfertigen Stand, und die Rückkehr zur Vorversion dauert nur Sekunden.
Wie viel Automatisierung braucht Ihre Website?
Die ehrliche Antwort: Es kommt darauf an. Nicht jede Website braucht eine komplexe DevOps-Infrastruktur mit aufwendig verzahnten Entwicklungs- und Betriebswerkzeugen. Kleine Websites brauchen einfache, aber saubere Abläufe. Geschäftskritische Systeme brauchen stärkere Kontrollmechanismen.
Welche Deployment-Strategie angemessen ist, hängt von 4 Faktoren ab:
- Risiko und Geschäftsrelevanz: Wie teuer wird ein Fehler? Eine Seite, über die Anfragen oder Bestellungen laufen, verzeiht weniger als eine reine Informationsseite.
- Projektgröße: Je mehr Funktionen, Schnittstellen und Abhängigkeiten, desto mehr kann bei einer Veröffentlichung schiefgehen.
- Aktualisierungsfrequenz: Wer wöchentlich veröffentlicht, profitiert schneller von festen Abläufen als jemand mit wenigen Updates im Jahr.
- Anzahl beteiligter Personen: Sobald mehrere Menschen Änderungen live stellen, braucht es einen gemeinsamen, dokumentierten Weg.
Auch bei hohem Automatisierungsgrad muss der Ablauf verständlich und dokumentiert bleiben. Zwei Fehler treten nämlich auch dann auf, wenn bereits automatisiert wird. Im ersten Fall ist die Pipeline technisch vorhanden, aber organisatorisch nicht in den Freigabeprozess eingebunden, sodass Änderungen trotzdem ohne Abnahme live gehen. Im zweiten Fall wurde die Automatisierung eingeführt, aber nie verständlich dokumentiert, und die Abhängigkeit von einer einzelnen Person besteht weiter, nur an anderer Stelle.
Unabhängig vom Umfang sollte deshalb eines feststehen: Produktiv-Deployments passieren bewusst, nicht nebenbei.
Checkliste: Woran Sie einen professionellen Deployment-Prozess erkennen
Mit diesen Fragen prüfen Sie den Deployment-Prozess Ihres Dienstleisters oder Ihres eigenen Teams:
- Gibt es eine Staging-Umgebung vor dem Livegang?
- Sind Deployments automatisiert?
- Ist klar definiert, wer Produktiv-Deployments freigeben darf?
- Werden Build- und Testschritte automatisch ausgeführt?
- Sind Zugangsdaten sicher hinterlegt?
- Wird dokumentiert, wann was live gegangen ist?
- Gibt es eine vorbereitete Rollback-Möglichkeit?
- Ist der Prozess dokumentiert, oder hängt er an einzelnen Personen?
- Ist der Ablauf auch für Projektleitung und Website-Verantwortliche verständlich erklärt?
Eine GitLab-Pipeline müssen Sie nicht selbst konfigurieren können. Sie sollten aber wissen, ob Ihr Dienstleister einen kontrollierten, dokumentierten und wiederholbaren Prozess nutzt. Wenn Sie mehrere Fragen mit Nein oder „weiß ich nicht“ beantworten, lohnt sich ein genauerer Blick.
Denn ein Deployment ist der Moment, in dem eine geschäftsrelevante Änderung öffentlich wird. Dieser Moment braucht einen Prozess.
Häufige Fragen zu automatisierten Deployments
Was ist ein automatisiertes Deployment?
Ein automatisiertes Deployment ist die Veröffentlichung einer Website-Änderung über einen festgelegten Ablauf statt über manuelle Einzelschritte. Prüfung, Bereitstellung auf einer Testumgebung, Freigabe und Livegang laufen jedes Mal gleich ab und werden dokumentiert. Schlägt ein Schritt fehl, stoppt der Prozess, bevor der Fehler online ist.
Brauche ich eine Staging-Umgebung, wenn meine Website klein ist?
Der Aufwand für eine Staging-Umgebung richtet sich nach Risiko und Änderungsfrequenz Ihrer Website. Kleine Websites kommen mit einer einfachen Lösung aus. Ganz ohne Testumgebung wird jede Änderung aber im Zweifel auf der Live-Website getestet, und Fehler bemerken dann oft zuerst Ihre Besucher:innen.
Muss ich GitLab CI/CD selbst bedienen können?
Nein. Die Pipeline einzurichten und zu betreuen, ist Aufgabe Ihres Entwicklungsteams oder Dienstleisters. Für Sie ist entscheidend, dass ein nachvollziehbarer Prozess existiert, Freigaben klar geregelt sind und Sie jederzeit erfahren können, was wann live gegangen ist.
Was passiert, wenn nach dem Livegang doch ein Fehler auftritt?
In einem professionellen Prozess ist der Rückweg vorbereitet. Weil dokumentiert ist, welche Version vorher online war, lässt sich dieser Stand gezielt wiederherstellen, in GitLab etwa durch erneutes Ausrollen eines früheren erfolgreichen Deployments. So muss niemand improvisieren, während der Fehler online bleibt.


